
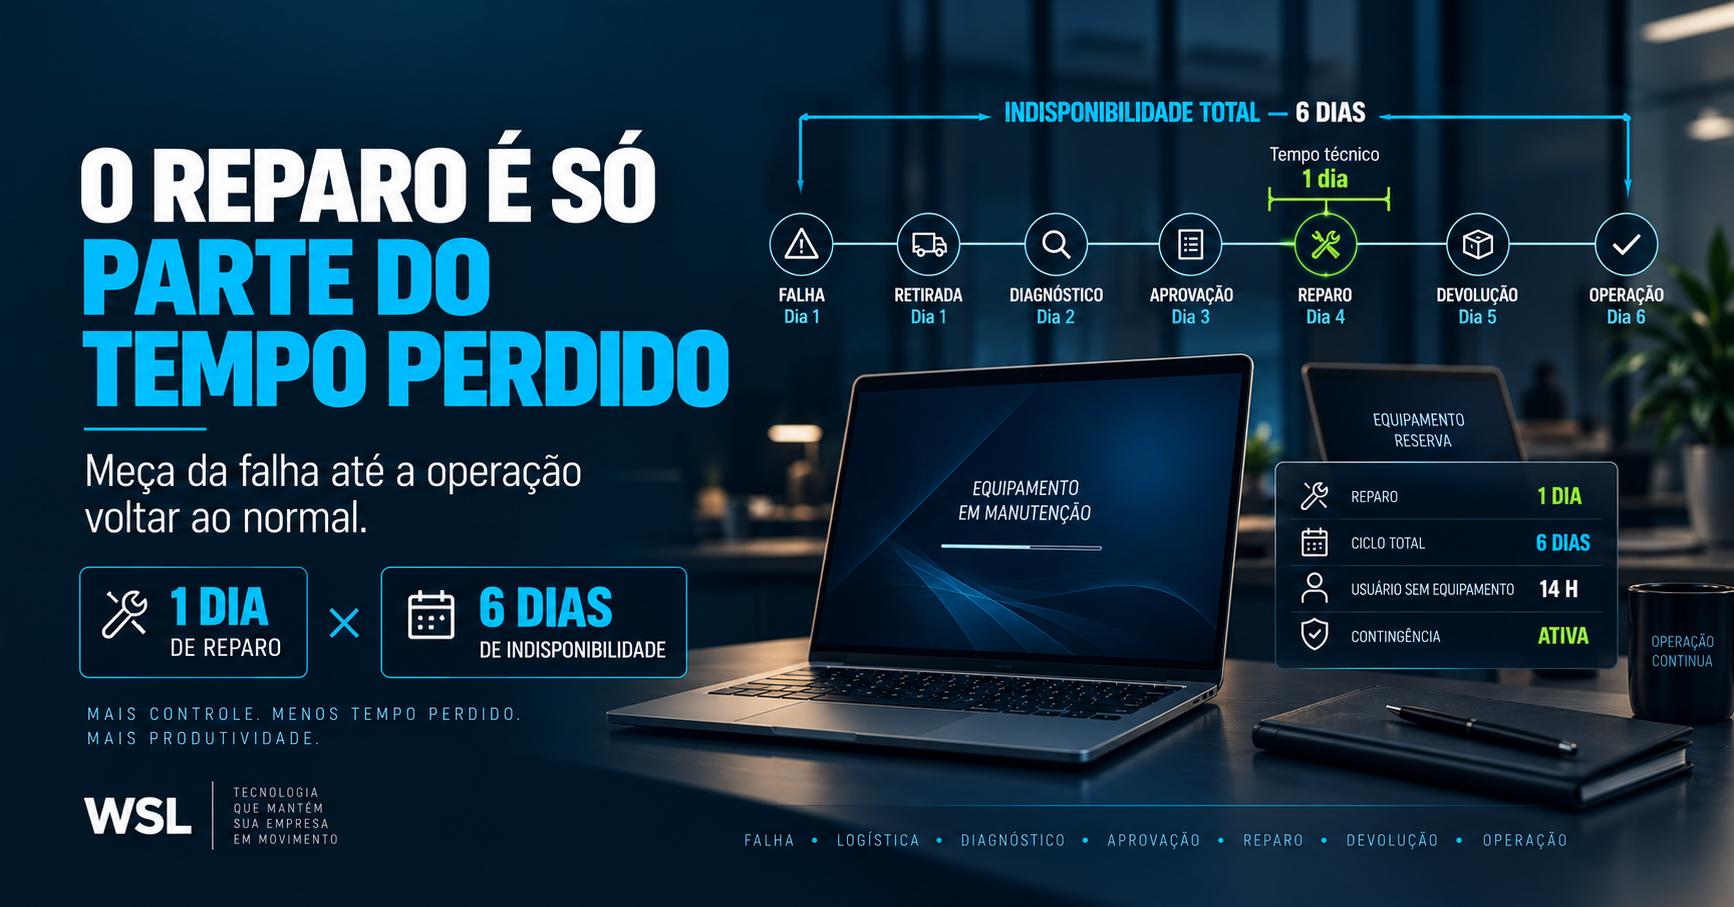
Quando um notebook corporativo apresenta falha, muitas empresas medem apenas uma parte do problema.
O tempo de reparo.
Mas o impacto real começa antes e termina depois.
O equipamento falha.
O usuário abre um chamado.
A TI analisa.
Alguém agenda a retirada.
O notebook é transportado.
O diagnóstico é realizado.
O orçamento é aprovado.
A peça é comprada.
O reparo acontece.
O equipamento é testado.
Depois precisa voltar para o colaborador.
É somente nesse momento que a operação realmente se normaliza.
Por isso, medir apenas quanto tempo a assistência levou para realizar o reparo pode esconder uma parte importante da realidade.
A métrica mais relevante é outra:
quanto tempo o usuário ficou sem o equipamento plenamente disponível para trabalhar?
Esse é o verdadeiro tempo de indisponibilidade.
O cronômetro não começa quando a assistência recebe o notebook
Imagine que um equipamento apresente problema na segunda-feira às 9h.
A retirada é solicitada apenas à tarde.
O notebook chega à assistência na terça-feira.
O diagnóstico fica pronto na quarta.
A aprovação acontece na quinta.
O reparo é concluído na sexta.
O equipamento retorna na segunda-feira seguinte.
Se alguém olhar apenas para o reparo físico, talvez conclua:
“O equipamento foi reparado em um dia.”
Mas o usuário ficou afetado durante praticamente uma semana.
As duas informações são verdadeiras.
Só que medem coisas completamente diferentes.
Indisponibilidade é uma cadeia
Uma forma mais completa de pensar o processo é:
Falha → Chamado → Triagem → Retirada → Diagnóstico → Aprovação → Reparação → Teste → Devolução → Retorno à operação
Cada etapa adiciona tempo.
E esse tempo pode vir de áreas diferentes.
A manutenção pode ser rápida, mas a aprovação pode levar dois dias.
O diagnóstico pode sair no mesmo dia, mas a logística pode atrasar.
A peça pode estar disponível, mas ninguém autorizou o orçamento.
Se a empresa mede apenas uma etapa, não consegue enxergar onde realmente estão os gargalos.
O impacto não é apenas técnico
Para o usuário, pouco importa onde o atraso aconteceu.
Se o notebook não está disponível, existe um impacto operacional.
Esse impacto pode aparecer como:
- colaborador ocioso;
- trabalho realizado de maneira limitada;
- uso de equipamento improvisado;
- perda de produtividade;
- atraso em tarefas;
- dificuldade para acessar sistemas;
- interrupção de reuniões;
- dependência de colegas;
- necessidade de notebook reserva.
Por isso, a indisponibilidade deveria ser tratada como um indicador de operação, não apenas de manutenção.
Uma máquina parada pode custar muito mais do que o reparo
Imagine um reparo de R$ 700.
Agora pense em um profissional cujo custo total para a empresa seja de R$ 15 mil por mês.
Se ele perde dias de produtividade por falta de equipamento, o custo operacional pode rapidamente superar o valor da manutenção.
E mesmo que o colaborador consiga trabalhar parcialmente, ainda existe perda.
Talvez ele use um computador reserva mais fraco.
Talvez não tenha todas as aplicações.
Talvez demore para configurar acessos.
Talvez precise reconstruir parte do ambiente.
Por isso, olhar apenas para o preço do reparo pode distorcer a tomada de decisão.
O tempo de aprovação costuma ser um gargalo invisível
Esse é um dos pontos mais comuns.
O diagnóstico sai rapidamente.
O orçamento é enviado.
E o processo para.
Aguardando aprovação.
Financeiro.
Gestor.
Compras.
Centro de custo.
Enquanto isso, o notebook continua indisponível.
Esse tempo raramente é atribuído à manutenção, mas faz parte do impacto total.
Se a empresa mede o ciclo completo, consegue perceber que talvez o maior problema não esteja no fornecedor técnico.
Está no processo interno.
A logística também pesa
Outro ponto importante é o deslocamento do equipamento.
Quanto tempo leva entre a falha e a retirada?
Quanto tempo leva entre o reparo concluído e a devolução?
A empresa possui unidades em diferentes regiões?
Os colaboradores trabalham em home office?
Existem janelas específicas para coleta?
Em operações descentralizadas, a logística pode representar uma parcela significativa do tempo total.
O diagnóstico precisa ser medido separadamente
A etapa de diagnóstico também merece um indicador próprio.
Quanto tempo passa entre a entrada do equipamento e a identificação do problema?
Isso ajuda a separar:
tempo de espera
de
tempo técnico.
Por exemplo:
Equipamento chegou às 10h.
Foi analisado às 16h.
Diagnóstico levou 40 minutos.
Do ponto de vista técnico, foram 40 minutos.
Do ponto de vista operacional, passaram-se mais de seis horas.
Os dois dados são úteis.
Reparar rápido não significa restaurar rápido
Uma assistência pode executar um reparo com excelente velocidade.
Mas, se o notebook fica parado antes e depois do reparo, o usuário continua impactado.
É por isso que empresas deveriam pensar em:
tempo para restaurar a operação
e não apenas:
tempo para consertar o equipamento.
Essa mudança de perspectiva é importante.
O objetivo da manutenção não é apenas devolver uma máquina tecnicamente funcional.
É devolver capacidade de trabalho.
Equipamento reserva muda completamente a equação
Agora imagine o mesmo cenário com um notebook reserva pronto.
O equipamento principal falha às 9h.
Às 10h, o usuário já está trabalhando em outra máquina.
O notebook defeituoso leva quatro dias para ser reparado.
Do ponto de vista técnico, houve quatro dias de manutenção.
Do ponto de vista operacional, talvez a indisponibilidade real tenha sido de apenas uma hora.
É por isso que o indicador deveria distinguir:
indisponibilidade do ativo
de
indisponibilidade do usuário.
São conceitos relacionados, mas diferentes.
O indicador pode mostrar se a contingência funciona
Se a empresa possui notebook reserva, vale medir:
Quanto tempo leva para disponibilizar?
Está pronto para uso?
Possui as aplicações necessárias?
O acesso está configurado?
O usuário precisa esperar horas para utilizá-lo?
Um equipamento reserva só reduz indisponibilidade se puder ser colocado em operação rapidamente.
Caso contrário, ele é apenas um notebook parado no estoque.
Crie duas métricas
Uma empresa pode começar com dois indicadores simples.
1. Tempo de indisponibilidade do equipamento
Da falha até o notebook original voltar à operação.
2. Tempo de indisponibilidade do usuário
Da falha até o colaborador conseguir voltar a trabalhar de maneira adequada, seja no equipamento original ou em uma contingência.
Essa distinção gera insights importantes.
Exemplo prático
Imagine:
08h30 — Falha
09h00 — Chamado aberto
11h00 — Notebook reserva disponibilizado
14h00 — Equipamento retirado
Dia seguinte — Diagnóstico
+1 dia — Aprovação
+1 dia — Reparação
+1 dia — Devolução
Nesse cenário:
Indisponibilidade do usuário: aproximadamente 2h30
Indisponibilidade do equipamento original: aproximadamente 4 dias
A manutenção demorou vários dias.
Mas a operação foi restaurada rapidamente.
Isso mostra uma gestão de contingência eficiente.
Meça o ciclo por etapas
Além do tempo total, vale registrar cada fase.
Por exemplo:
Falha até abertura do chamado
Chamado até retirada
Retirada até diagnóstico
Diagnóstico até aprovação
Aprovação até reparo
Reparo até devolução
Devolução até retorno à operação
Com isso, a empresa consegue identificar onde estão os maiores atrasos.
Transforme o indicador em ação
O objetivo não é criar uma planilha sofisticada apenas para gerar relatório.
O indicador precisa responder:
Onde estamos perdendo tempo?
Se o atraso está na retirada, reveja a logística.
Se está na aprovação, reveja alçadas e limites.
Se está no diagnóstico, reveja fornecedor ou capacidade técnica.
Se está em peças, avalie estoque crítico.
Se está na configuração do reserva, padronize imagens e acessos.
A métrica só gera valor quando influencia o processo.
Crie metas por criticidade
Nem todos os usuários precisam do mesmo SLA.
Um notebook de uso eventual não possui a mesma criticidade de um equipamento utilizado por uma função essencial.
A empresa pode classificar:
Baixa criticidade
Tolerância maior.
Média criticidade
Necessidade de contingência em período definido.
Alta criticidade
Substituição ou restauração rápida.
Isso evita tratar todos os incidentes igualmente.
O histórico começa a revelar padrões
Depois de alguns meses, a empresa consegue descobrir:
Qual modelo fica mais tempo parado?
Qual fornecedor demora mais?
Quais peças causam maior atraso?
Quais áreas aprovam reparos mais lentamente?
Quantos usuários precisaram de contingência?
Qual é o tempo médio para restaurar o trabalho?
Essas respostas são extremamente úteis.
Um SLA bom precisa olhar para o negócio
Existe um erro comum em contratos de manutenção.
Medir apenas:
“diagnóstico em 24 horas”
ou
“reparo em até X dias”.
Esses SLAs são importantes.
Mas podem não representar o que o negócio realmente precisa.
Talvez o indicador mais relevante seja:
“Usuário crítico volta a trabalhar em até 4 horas.”
Isso muda a estratégia.
Talvez a solução não seja reparar em quatro horas.
Pode ser disponibilizar contingência em quatro horas e reparar com calma depois.
Custo de indisponibilidade deveria influenciar decisões
Quando a empresa conhece o tempo médio de indisponibilidade, consegue calcular impacto.
Por exemplo:
Tempo médio sem equipamento × custo da hora do usuário × número de incidentes
Não será um cálculo perfeito.
Mas oferece uma referência.
Isso ajuda a avaliar se faz sentido investir em:
- notebooks reserva;
- manutenção preventiva;
- estoque de peças;
- logística dedicada;
- contratos de atendimento;
- padronização.
Quanto maior o parque, mais importante medir
Em uma empresa com 10 notebooks, um incidente é pontual.
Em uma empresa com 500, falhas se tornam estatisticamente recorrentes.
Mesmo com uma taxa baixa, haverá equipamentos em manutenção todos os meses.
Nesse cenário, reduzir algumas horas do ciclo médio pode representar um ganho operacional significativo ao longo do ano.
O verdadeiro indicador é o tempo para recuperar capacidade de trabalho
Esse é o ponto central.
A empresa não deveria medir apenas quanto tempo levou para:
consertar um notebook.
Deveria medir quanto tempo levou para:
restaurar a capacidade de trabalho do usuário.
Essa é a diferença entre olhar para manutenção como uma oficina e enxergá-la como parte da continuidade operacional.
Quando esse indicador passa a ser acompanhado, decisões sobre logística, aprovação, contingência, estoque e fornecedores ficam muito mais objetivas.
Porque, no fim, o problema de um notebook parado não é o notebook parado.
É o trabalho que deixou de acontecer enquanto ele estava fora de operação.
